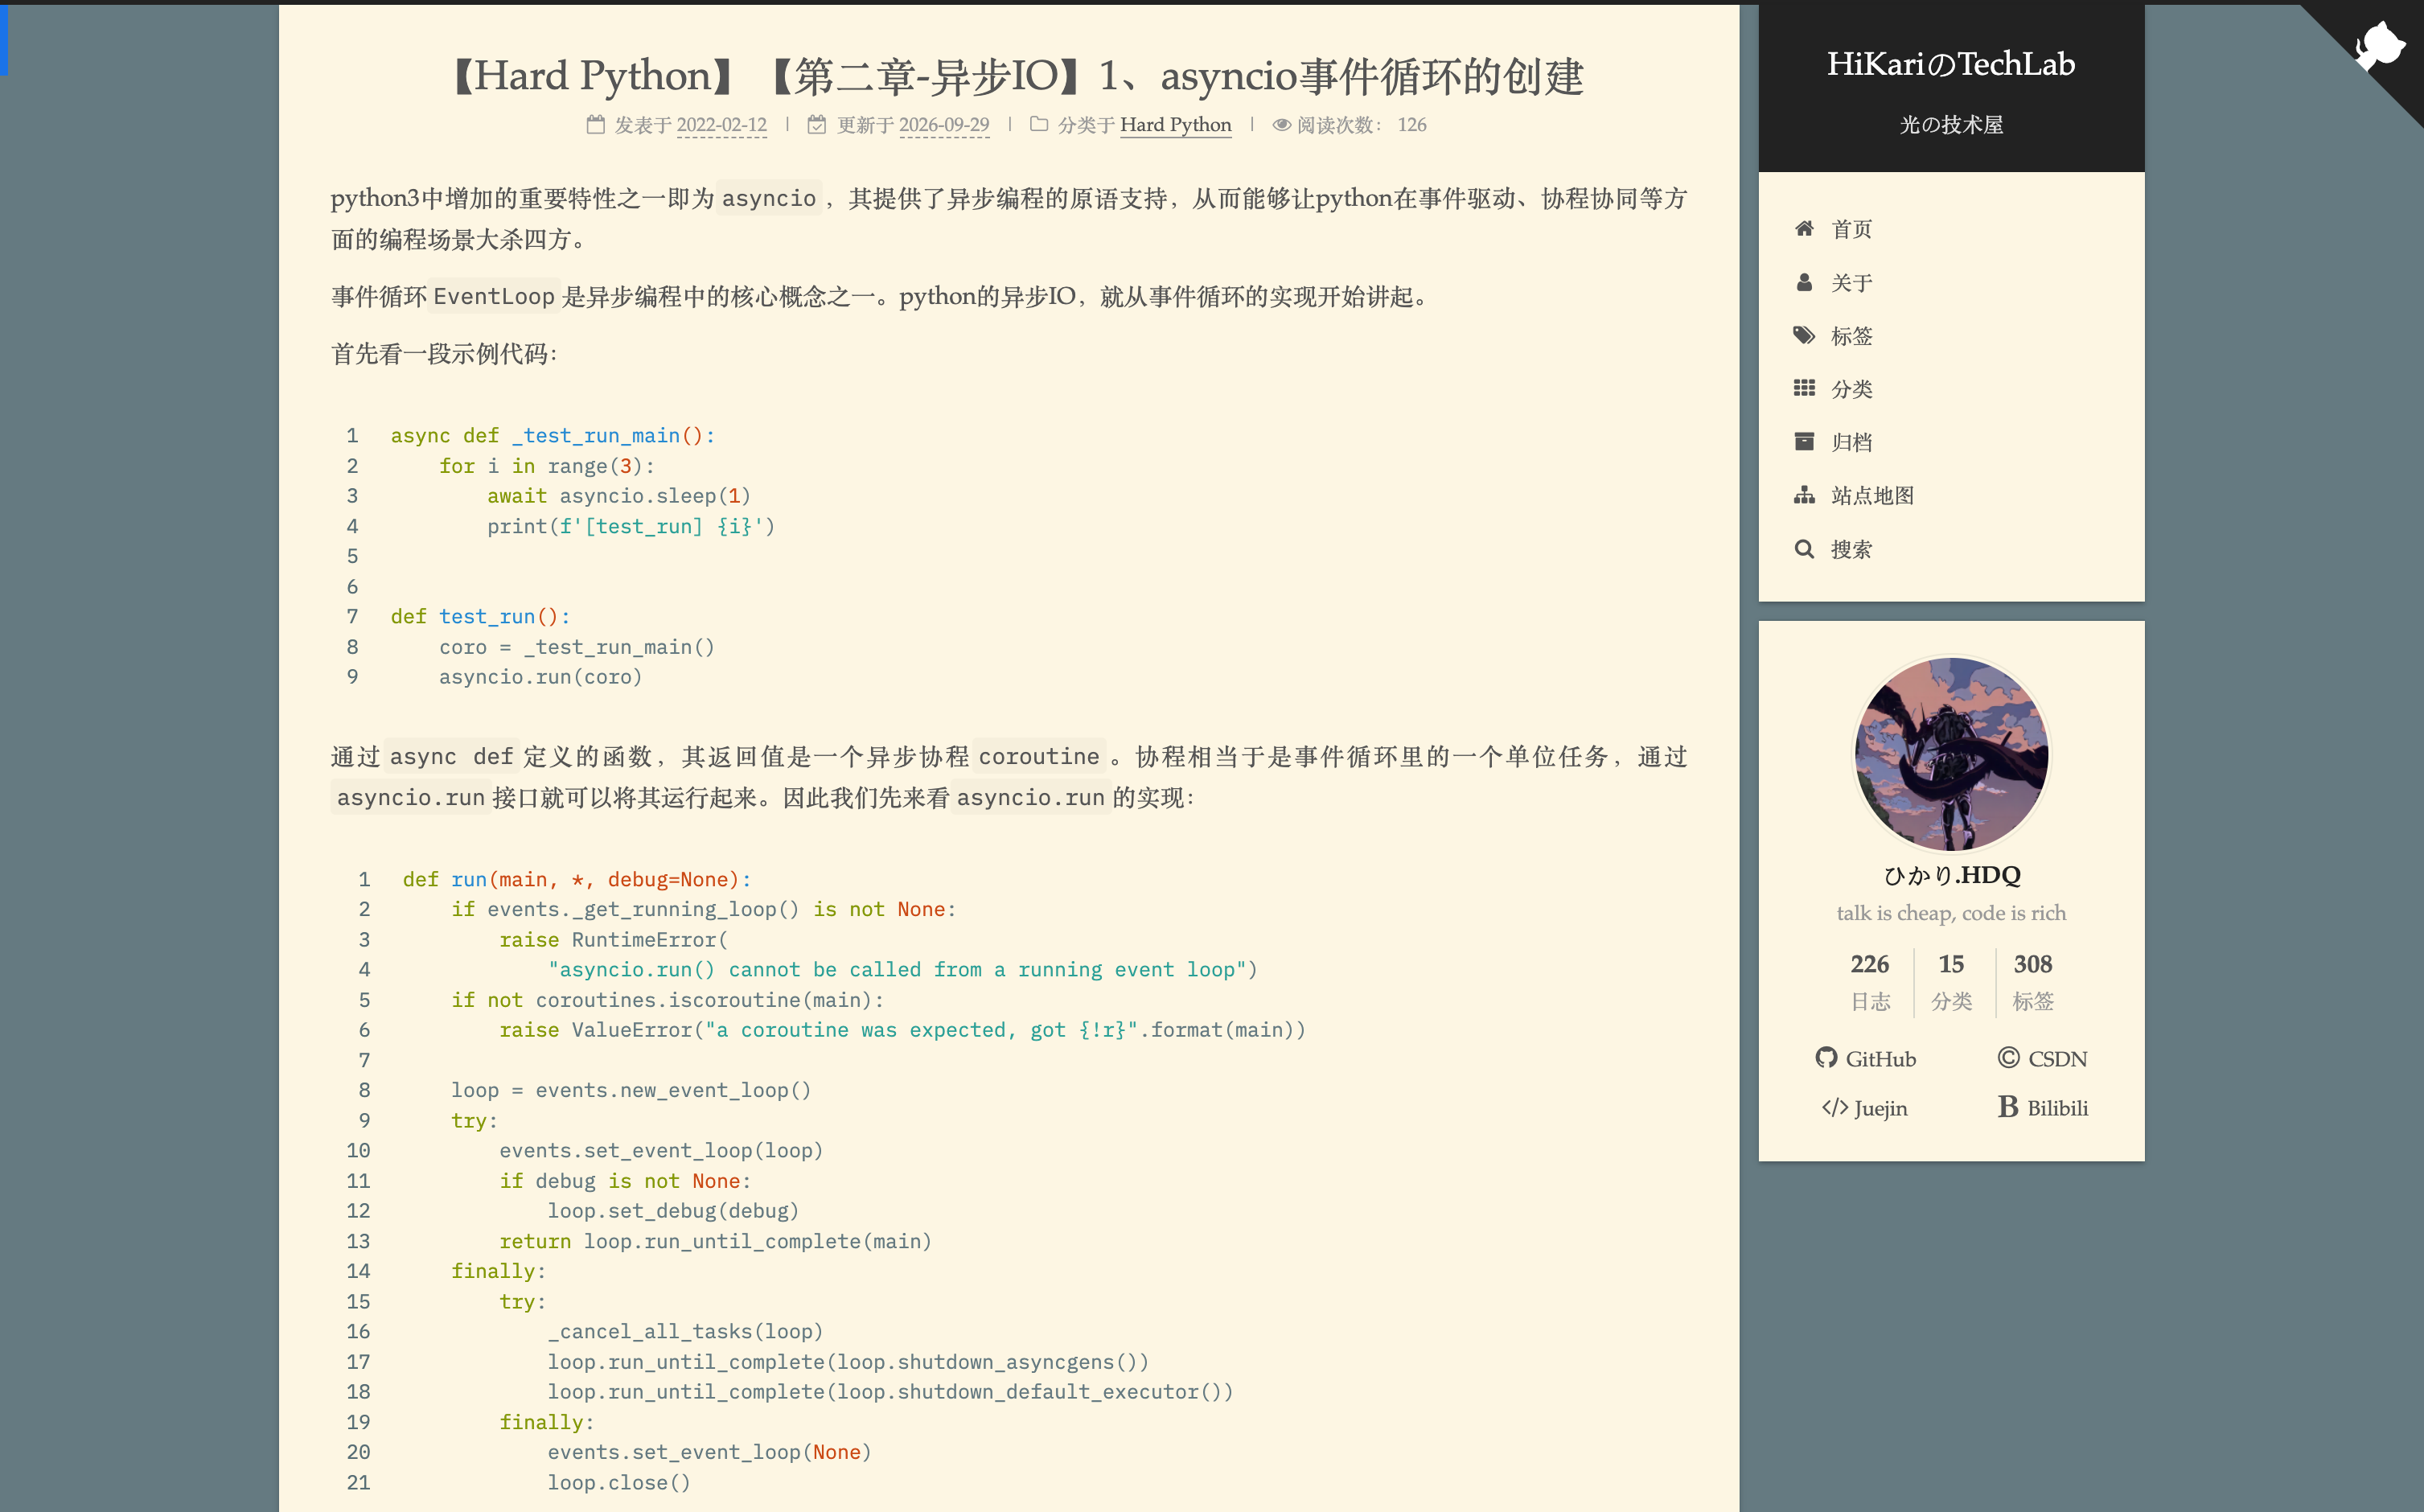
恰逢中秋十一假期,想到自己的个人博客已经很久没有做前端优化了,趁着这段时间决定借助AI Coding的力量,把博客的前端样式整体优化一下,调整到自己预期内的效果。不得不说现在即便是很廉价的模型,最终都能够达成这个目标,因此打算写这篇博客,记录一下自己优化的历程。
先说结果,新的博客前端,主要优化了下面一些事情:
- 字体调整:默认采用衬线字体,文本展现更加美观,尤其在Mac上效果更好;
- 标签优化:聚合删减了100个左右的标签;
- 颜色调整:搜索页、按钮和Scroll的背景色,全部调成和Solarized体系搭配的颜色,代码染色也和Solarized Light对标。
具体执行时,还是踩了一些坑,最终也都得到解决。
首先字体方面遇到的是兼容性问题,主要是Windows下渲染中文衬线字体,默认Win10、Win11有的宋体展现非常丑,其他一些字体比如Noto Serif SC这种,如果不增加描边的话,在不同ClearType配置下可能会显得非常浅看不清,但描边的话也并非能够兼容所有Windows电脑的配置,所以这里退而求其次,直接全部上微软雅黑,但英文还是保留Palatino Linotype跟Georgia的兜底。其它设备上目前看起来还好,至少Mac、iPhone跟华为机子上还没看出啥问题,如果哪台机子有兼容性问题,也欢迎做下反馈。
代码字体方面,根据自己经验,统一用了IBM Plex Mono这个更加重视观感的字体,外加上对字体大小跟code配色的调整,像以前asyncio源码分析这类文章整体的观感也更加出色了。
染色方面,笔者还是决定继续用Solarized比较柔和的观感,主要的背景色维持比Solarized Dark浅一些,这样阅读起来不会显得对比度太高。其它一些简单的Bugfix,比如正文Card和页面Footer黏住,正文字体大小适当调小,跟Title的Margin这种细微调整,都在这次整改中搞定了,可以说是非常爽快。
有了AI,自己的NexT vendor短期也不需要更新了,完全可以自给自足,说到底这次整改最大的功劳还是归功于咱们很多廉价的模型。从体验上来讲,截至今日性价比最高的模型还是DeepSeek-v4.1-Flash,然后表现最全面均衡的还是Qwen3.8系列,上述的事情都是用这两套模型搞定的。其他的GLM和Kimi是各有千秋,GLM5.3-Flash也不错,GLM5.3跟Kimi消耗Token就相对高些,因为没有特别重的需求,所以这次还没有用上。
也顺带提一嘴,工业生产环境上,如果考虑Token性价比的话,短平快的任务此时此刻还是推荐DeepSeek-V4.1-Flash,长程任务可以考虑Qwen3.8、GLM5.3跟Kimi-K3系列。但要注意几点:
- 很多模型长程任务会一步步推导,本质上在模型训练时候就往高Token消耗的路线走,所以如果对效率有所追求的话需要着重Harness下;
- 现在类似Qwen3.8的模型,虽然独立工作很优秀,但可能有比较严重的自言自语问题,交流时只输出一些只有模型自己理解的事情,并不是按照正常和人工作交流的目的去输出结论的,所以如果遇到看不懂结论的情况,建议就是让AI重新叙述一遍,或者Harness下AI的输出规范,减少沟通成本。
最后也展示下,现在博文在Mac上的效果,相比以前明显格局更高了。